统一且稳定的 API 接口
使用 APIAny 密钥和明确的请求格式调用 Gemini 3.1 Flash Lite。上游路由或模型版本变化时,应用侧集成仍可保持稳定。
Sampling temperature. Lower is more deterministic.
Optional reasoning effort. Leave unset to use the model default. Higher effort can use more tokens and time.
美元估算 $0.0015-$0.003:最高充值套餐按 $1 = 2,000 积分计算;入门套餐按 $1 = 1,000 积分计算。
历史记录
保存在此浏览器本地
0 个运行中 · 0 个已完成
输入
≈ $0.0001-$0.0003
输出
≈ $0.001-$0.002
缓存读取
≈ $0.000013-$0.000025
上下文
最大输出
鉴权
每个请求都需要在 Authorization 头中携带 Bearer 令牌。请在控制台创建 API Key。
Authorization: Bearer YOUR_API_KEYhttps://apiany.ai/v1/chat/completions请求参数
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
model | 字符串 | 必填 | 要调用的模型标识,使用该模型的 ID。 |
messages | 数组 | 必填 | OpenAI 对话格式的消息历史(role + content)。 |
stream | 布尔值 | 可选 | 为 true 时,响应将以 SSE 流式返回。 |
请求示例
curl "https://apiany.ai/v1/chat/completions" \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "gemini-3.1-flash-lite",
  "messages": [
    {
      "role": "user",
      "content": "Summarize the following text in three concise bullet points:"
    }
  ],
  "temperature": 0.7,
  "max_tokens": 1024
}'
响应示例
{
  "id": "chatcmpl-abc123",
  "object": "chat.completion",
  "model": "gemini-3.1-flash-lite",
  "choices": [
    {
      "index": 0,
      "message": {
        "role": "assistant",
        "content": "Hello! How can I help?"
      },
      "finish_reason": "stop"
    }
  ],
  "usage": {
    "prompt_tokens": 12,
    "completion_tokens": 18,
    "total_tokens": 30
  }
}模型概览
Google Gemini 3.1 Flash Lite 在 2.5 代基础上升级了推理能力,同时保持经济实惠的调用成本,兼顾速度与质量,适合高频轻量级任务、批量内容生成与轻量级 Agent 调用,所有请求均可通过 APIAny 的 OpenAI 兼容 API 直接调用,并可在线预览效果。
根据该模型服务的运营目标,衡量吞吐量、延迟、审核工作量和单位经济性。
Gemini 3.1 Flash Lite 通过 APIAny 以统一、有文档说明的接口提供,同一页展示实时价格、模型状态、请求示例和 Playground。团队可以先在此评估,再在同一平台管理鉴权、用量记录和生产路由。
在 Playground 中试用 Gemini 3.1 Flash Lite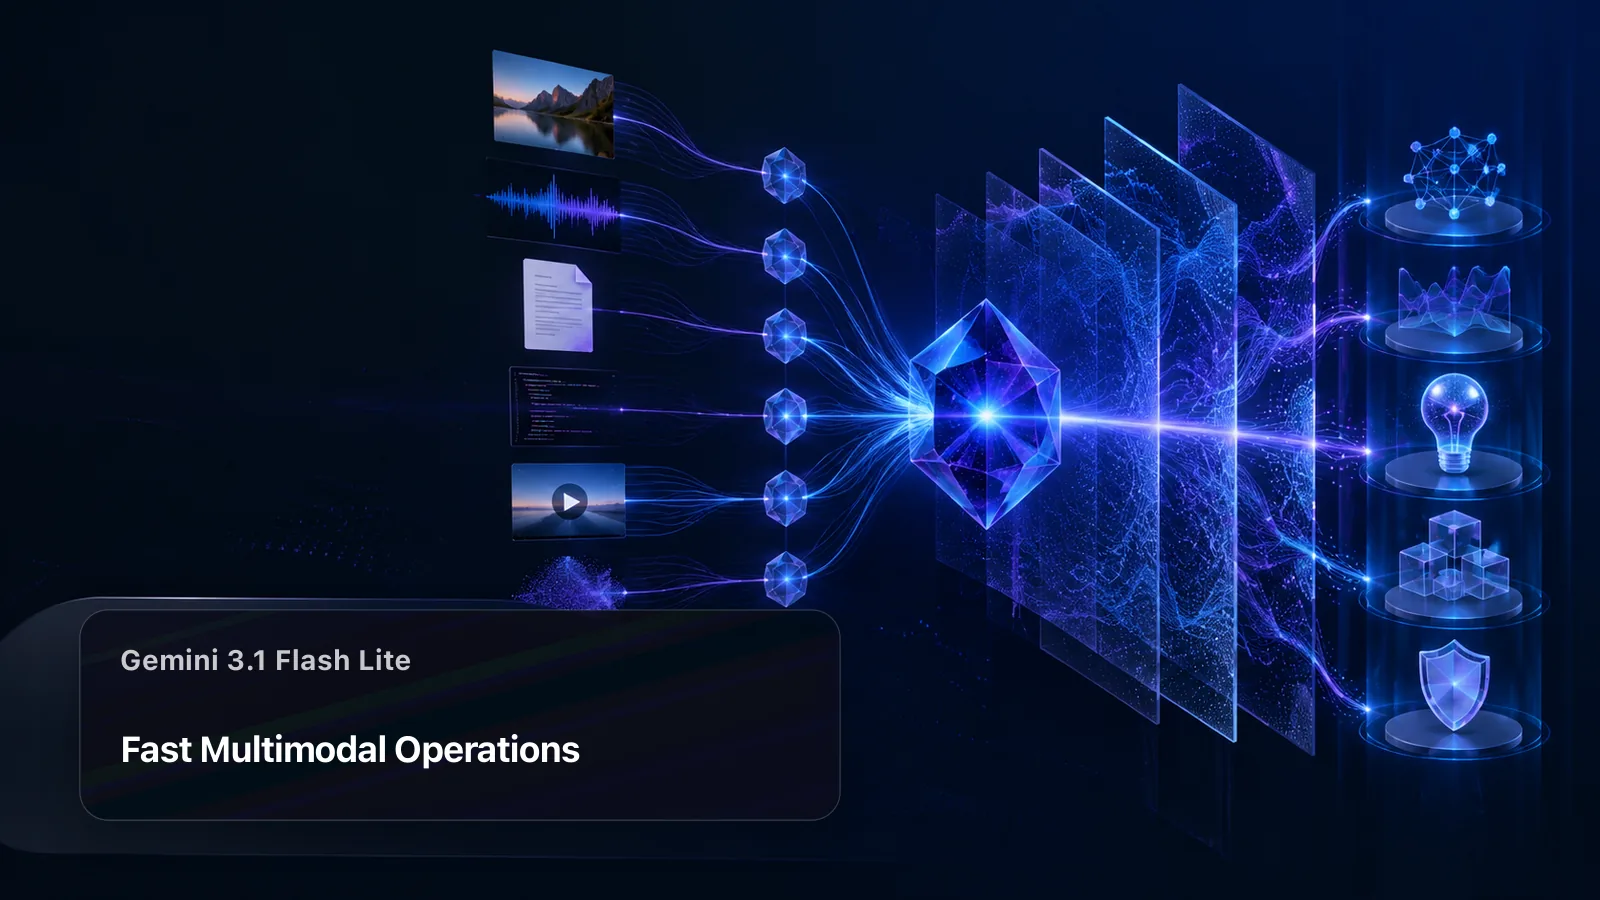
来源
以下引文来自 APIAny 对照实现的官方 API 文档。
The Gemini API provides access to Google's most capable generative AI models.
The Chat Completions API endpoint will generate a model response from a list of messages comprising a conversation.
APIAny 优势
在 APIAny 上使用 Gemini 3.1 Flash Lite,就是一把密钥、实时价格、状态与用量记录组成的生产路由,无需为每个供应商维护独立集成。
使用 APIAny 密钥和明确的请求格式调用 Gemini 3.1 Flash Lite。上游路由或模型版本变化时,应用侧集成仍可保持稳定。
请求前查看 Gemini 3.1 Flash Lite 的实时计费规则和 Playground 预估积分,请求完成后再核对请求级用量记录。
结合模型状态、通道健康、重试策略和用量日志,将 Gemini 3.1 Flash Lite 作为生产工作流的一部分稳定运行,而不只是用于单次演示。
应用场景
Gemini 3.1 Flash Lite API 用于需要该模型输出的产品工作流。先在 Playground 用同一组输入测试,再与相关模型比较,并按质量、延迟和预算选择路由。
01
使用 Gemini 3.1 Flash Lite 完成支持请求分类、回复草拟、自助指引和多语言对话。结合检索与策略检查,让回答基于最新产品信息。
在 Playground 中试用 Gemini 3.1 Flash Lite
02
通过 Gemini 3.1 Flash Lite 将消息和文档转换为标签、字段或 JSON。为输出定义严格结构,并在触发下游自动操作前验证结果。
在 Playground 中试用 Gemini 3.1 Flash Lite
接入方式
接入 Gemini 3.1 Flash Lite API 是从 Playground 测试到鉴权生产请求的三步路径。本页同时提供模型标识、请求结构、价格和返回示例。 使用受控输入、可观测任务状态以及明确的升级或回退路径完成部署。
登录 APIAny,为项目创建 API 密钥,并只分配应用实际需要的模型范围和预算限制。
复制本页请求示例,将 model 字段设为选中的 Gemini 3.1 Flash Lite 版本,然后发送至文档所示的 APIAny 端点。
跟踪状态、延迟、积分和返回用量。在切换生产流量前,用同一类任务比较不同版本或相关模型。
核心能力
Gemini 3.1 Flash Lite API 功能是评估该模型时需要关注的输入、输出和工作流特征。当前可用参数仍以本页实时 API Reference 为准。
/01
在交互体验、快速迭代和响应时间敏感的任务中选择更快的 Gemini 3.1 Flash Lite 路由。
/02
结合实时价格和请求级用量记录运行更大规模的 Gemini 3.1 Flash Lite 任务并控制支出。
/03
使用较大的上下文窗口处理代码库、文档、会话历史和多步指令,同时关注 Token 成本。
/04
在同一工作流中组合受支持的文字和视觉输入,让 Gemini 3.1 Flash Lite 理解多种内容格式。
/05
使用 Gemini 3.1 Flash Lite 拆解多步骤问题、比较备选方案并输出便于审核的结构化结论。
/06
逐步展示受支持的 Gemini 3.1 Flash Lite 文本输出,用于交互助手和耗时较长的生成任务。
FAQ
集中解答 Gemini 3.1 Flash Lite 的能力、应用场景、接入方式和版本选择问题。
Google Gemini 3.1 Flash Lite 在 2.5 代基础上升级了推理能力,同时保持经济实惠的调用成本,兼顾速度与质量,适合高频轻量级任务、批量内容生成与轻量级 Agent 调用,所有请求均可通过 APIAny 的 OpenAI 兼容 API 直接调用,并可在线预览效果。 APIAny 让该模型可以通过带身份验证的 API 调用,并在同一页面提供实时价格、状态信息、请求示例和在线 Playground。
Gemini 3.1 Flash Lite 的常见工作流包括:客户支持助手, 分类与结构化提取, 多语言助手。具体是否适合,取决于产品要求的输入格式、输出质量、响应延迟和成本。
创建 APIAny 密钥,使用本页文档中的端点,并将请求的 model 字段设为选中的 Gemini 3.1 Flash Lite 版本。正式接入代码前,可以先用 Playground 生成一份可运行的请求。
03
使用 Gemini 3.1 Flash Lite 构建跨语言理解和回复的助手。上线前应使用有代表性的对话测试术语、语气、本地格式和策略行为。
在 Playground 中试用 Gemini 3.1 Flash Lite
根据本页展示的价格、支持参数以及 低延迟执行, 高性价比扩展, 长上下文处理 等能力比较不同版本。建议先用一条有代表性的生产输入完成测试,再确定默认路由。